
Eine Publikation hat einen Titel. Eine Person hat einen Namen. Eine Universität hat eine Adresse. Warum brauchen wir dann zusätzlich noch kryptische Zeichenfolgen wie 10.1000/xyz123, 0000-0002-1825-0097 oder https://ror.org/03yrm5c26?
Die kurze Antwort: Weil Namen und Titel nicht eindeutig sind.
Mehrere Menschen können denselben Namen tragen. Eine Person kann ihren Namen ändern, mit Initialen publizieren oder in verschiedenen Datenbanken unterschiedlich geschrieben werden. Besonders Umlaute und Sonderzeichen verursachen dabei Probleme. Einrichtungen werden umbenannt, fusionieren oder besitzen Namen in mehreren Sprachen. Und selbst Publikationstitel sind weniger verlässlich, als man zunächst vermuten würde: Sie können Tippfehler enthalten, übersetzt werden oder nahezu identisch zu anderen Titeln sein.
Identifier lösen dieses Problem. Sie geben Personen, Publikationen, Organisationen und anderen Objekten eine eindeutige Kennung. In einem Forschungsinformationssystem wie OSIRIS sind sie deshalb weit mehr als ein technisches Detail: Sie helfen dabei, Daten korrekt zuzuordnen, Dubletten zu vermeiden, Informationen aus verschiedenen Quellen zusammenzuführen und Einträge automatisch anzureichern.
Was ist ein Persistent Identifier?
Ein Identifier ist zunächst einfach eine eindeutige Kennung für ein bestimmtes Objekt. Ein Persistent Identifier, kurz PID, geht einen Schritt weiter: Er soll langfristig stabil bleiben und das Objekt auch dann noch auffindbar machen, wenn sich beispielsweise dessen Webadresse ändert.
Eine normale URL beschreibt, wo etwas gerade zu finden ist. Ein Persistent Identifier beschreibt, was es ist.
Das lässt sich mit einem Umzug vergleichen. Wenn eine Zeitschrift ihre Webseite neu strukturiert oder ein Repositorium auf einen anderen Server umzieht, kann eine alte URL ins Leere führen. Eine DOI bleibt dagegen gleich. Im Hintergrund wird lediglich aktualisiert, auf welche aktuelle Adresse sie verweist.
Nicht jede in der Forschung verwendete Kennung ist im engen technischen Sinn ein Persistent Identifier. ISBN, PMID oder arXiv-IDs haben jeweils eigene Regeln und Infrastrukturen. Für die Praxis eines Forschungsinformationssystems ist aber vor allem entscheidend, ob eine Kennung ein Objekt zuverlässig identifiziert und damit die Verknüpfung mit anderen Datenquellen ermöglicht.
Warum Forschungsinformationssysteme Identifier brauchen
Ein Forschungsinformationssystem bringt Informationen aus vielen Quellen zusammen: Forschende tragen Aktivitäten selbst ein, Publikationen werden importiert, Projekte kommen aus Verwaltungsprozessen und Organisationen werden mit externen Partnern verknüpft. Ohne eindeutige Kennungen müsste das System immer wieder anhand von Namen, Titeln und anderen Textfeldern raten, ob zwei Datensätze dasselbe meinen.
Identifier schaffen hier verlässliche Anker. Sie ermöglichen unter anderem:
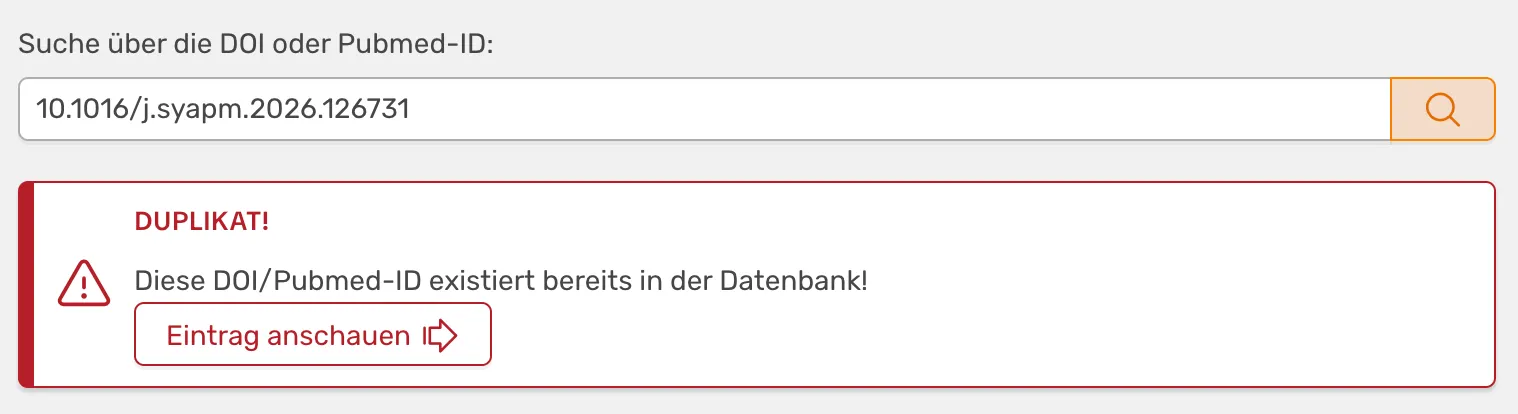
- Deduplikation: Zwei Einträge mit derselben DOI bezeichnen dieselbe Publikation und sollten nicht doppelt angelegt werden.
- Automatischen Import: Über eine DOI, ORCID oder ROR-ID lassen sich strukturierte Metadaten aus öffentlichen Diensten abrufen.
- Sichere Verknüpfungen: Personen, Publikationen und Organisationen können auch über Systemgrenzen hinweg eindeutig miteinander verbunden werden.
- Bessere Datenqualität: Standardisierte Metadaten reduzieren Tippfehler, uneinheitliche Schreibweisen und unvollständige Angaben.
- Nachhaltige Auffindbarkeit: Verweise bleiben stabiler, selbst wenn sich Webseiten oder technische Systeme verändern.
- Interoperabilität: Daten aus OSIRIS lassen sich leichter mit Repositorien, Bibliothekskatalogen, Forschungsportalen und anderen Informationssystemen austauschen.
Dabei gilt grundsätzlich: Je mehr passende und geprüfte Identifier vorhanden sind, desto besser. Eine große Zahl ungeprüfter Kennungen hilft allerdings nicht weiter. Entscheidend ist, dass jede ID dem richtigen Objekt zugeordnet ist.
Die wichtigsten Identifier auf einen Blick
| Identifier | Identifiziert | Besonders relevant für | Typisches Beispiel |
|---|---|---|---|
| DOI | Publikationen, Datensätze, Software und weitere Forschungsobjekte | nahezu alle Disziplinen | Zeitschriftenartikel oder Forschungsdatensatz |
| ORCID iD | Forschende und andere Mitwirkende | disziplinübergreifend | eindeutige Zuordnung einer Person |
| ROR ID | Forschungsorganisationen | disziplinübergreifend | Universität, Institut oder Förderorganisation |
| ISBN | einzelne Ausgaben von Büchern | besonders Geistes- und Sozialwissenschaften | Monografie oder Sammelband |
| ISSN | fortlaufende Publikationen | Zeitschriften und Schriftenreihen | wissenschaftliche Fachzeitschrift |
| PMID | Datensätze in PubMed | Medizin und Lebenswissenschaften | biomedizinischer Fachartikel |
| PMCID | frei zugängliche Volltexte in PubMed Central | Medizin und Lebenswissenschaften | archivierter Volltext eines Artikels |
| arXiv-ID | Preprints in arXiv | Physik, Mathematik, Informatik und verwandte Fächer | Preprint |
| Handle oder URN | digitale Objekte in Repositorien | institutionelle Publikationen und digitale Sammlungen | Hochschulschrift oder Repositoriumseintrag |
| Accession Number | Einträge in Fachdatenbanken | unter anderem Lebens- und Geowissenschaften | Sequenz, Struktur oder Probendatensatz |
| OpenAlex ID | Forschungsobjekte im OpenAlex-Wissensgraphen | Analyse und Datenverknüpfung | Werk, Person, Institution oder Topic |
Diese Liste ist nicht vollständig. Je nach Fachgebiet können weitere Kennungen wichtig sein, etwa Patentnummern, Clinical-Trial-IDs, Identifikatoren für Förderprojekte oder IDs spezialisierter Fachdatenbanken. Der zentrale Gedanke bleibt aber immer derselbe: Unterschiedliche Identifier identifizieren unterschiedliche Arten von Dingen.
DOI: Der wichtigste Identifier für Publikationen in OSIRIS
Der Digital Object Identifier, kurz DOI, ist heute eine der wichtigsten Kennungen für wissenschaftliche Publikationen. Er wird unter anderem für Zeitschriftenartikel, Buchkapitel, Bücher, Konferenzbeiträge, Forschungsdaten, Berichte und Software vergeben. Dabei werden sie zentral von offiziellen Registrierungsstellen wie Crossref oder DataCite vergeben.
Für OSIRIS ist die DOI besonders wertvoll, weil sie gleich mehrere Aufgaben übernimmt.
Dubletten vermeiden
Bevor eine Publikation neu angelegt wird, kann OSIRIS prüfen, ob ihre DOI bereits im System vorhanden ist. Das ist wesentlich zuverlässiger als ein Vergleich von Titeln oder Autorenlisten. Schon kleine Unterschiede – ein fehlender Untertitel, andere Großschreibung oder ein zusätzlicher Bindestrich – können einen reinen Textvergleich erschweren. Die DOI bleibt dagegen eindeutig. OSIRIS normalisiert die DOI für diesen Prozess, transformiert sie in Kleinschreibung und entfernt ggf. die URL.
Metadaten automatisch importieren
Statt Titel, Autor:innen, Zeitschrift, Erscheinungsjahr und weitere Angaben von Hand einzugeben, reicht in vielen Fällen die DOI. OSIRIS fragt die dazugehörigen Metadaten automatisiert aus öffentlichen Diensten ab.
Der Import erfolgt dabei schrittweise:
- Zunächst sucht OSIRIS die DOI bei Crossref, einer der wichtigsten Registrierungsstellen für DOIs wissenschaftlicher Publikationen.
- Ist dort kein Datensatz vorhanden, wird die DOI bei DataCite gesucht. DataCite spielt insbesondere für Forschungsdaten, Software und weitere Forschungsobjekte eine wichtige Rolle.
- Anschließend ergänzt OSIRIS den Eintrag mit Informationen aus OpenAlex. Das können beispielsweise Open Access-Informationen sein, die es in zuvor genannten Quellen nicht gibt, aber auch Zitationszahlen und thematische Zuordnungen, die in OSIRIS für das Forschungsspektrum genutzt werden, stammen aus OpenAlex.
Aus einer einzigen Kennung entsteht so ein weitgehend ausgefüllter und mit weiteren Informationen angereicherter Datensatz. Das spart Zeit und sorgt gleichzeitig für einheitlichere Metadaten.
Die DOI ist in OSIRIS nicht nur ein Link zu einer Publikation. Sie ist der Schlüssel für Import, Anreicherung und Deduplikation.
Eine DOI allein garantiert allerdings noch keine perfekten Metadaten. Auch Registrierungsdaten können unvollständig oder fehlerhaft sein. Deshalb sollten importierte Angaben weiterhin geprüft werden – insbesondere Namen, Publikationstypen und institutionelle Zuordnungen.
ORCID iD: Eine eindeutige Kennung für Personen
Bei Personen ist die eindeutige Zuordnung besonders schwierig. Namen können mehrfach vorkommen, sich ändern oder in Publikationen unterschiedlich abgekürzt werden. Sonderzeichen werden nicht in allen Systemen gleich dargestellt. Auch ein Wechsel der Institution darf nicht dazu führen, dass das wissenschaftliche Profil einer Person auseinanderfällt.
Die ORCID iD bietet hierfür eine dauerhafte, international etablierte Kennung. Sie gehört der Person und kann sie über verschiedene Einrichtungen, Verlage und Forschungsprojekte hinweg begleiten. Forschende können in ihrem ORCID-Profil unter anderem Publikationen, Beschäftigungen, Ausbildungen und weitere wissenschaftliche Tätigkeiten hinterlegen.
Mit OSIRIS 2.1 wurde die ORCID-Anbindung deutlich erweitert. Wenn eine Institution die Integration eingerichtet und die erforderlichen API-Zugangsdaten hinterlegt hat, können Nutzende ihre ORCID iD direkt mit OSIRIS verbinden und authentifizieren. Damit wird nicht nur eine Nummer in ein Profil eingetragen: Die Person bestätigt über ORCID, dass sie Zugriff auf das zugehörige Konto besitzt. Und dadurch eröffnen sich neue Möglichkeiten.
Denn anschließend können Daten aus ORCID nach OSIRIS importiert werden. Das erleichtert die Pflege des eigenen Profils und schafft eine zusätzliche Brücke zwischen dem institutionellen Forschungsinformationssystem und der internationalen Forschungsinfrastruktur.
Wichtig ist die Unterscheidung: Eine authentifizierte ORCID iD bestätigt die Verbindung zwischen dem OSIRIS-Konto und dem ORCID-Konto. Sie ist kein allgemeiner Identitätsnachweis und sagt für sich allein noch nichts über die Qualität sämtlicher Einträge im ORCID-Profil aus.
ROR: Eindeutige Organisationen statt vieler Schreibweisen
Auch Organisationen sind ohne Identifier erstaunlich schwer zu verwalten. Eine Universität kann unter ihrem deutschen Namen, einer englischen Übersetzung oder einer Abkürzung erscheinen. Institute werden umbenannt, ausgegründet oder zusammengelegt. Hinzu kommen unterschiedliche Schreibweisen und Hierarchieebenen.
Die Research Organization Registry, kurz ROR, vergibt offene Kennungen für Forschungsorganisationen. Ein ROR-Datensatz enthält neben dem bevorzugten Namen unter anderem alternative Namen, den Standort, die Webseite und Beziehungen zu anderen Organisationen.
OSIRIS nutzt ROR beim zentralen Anlegen von Organisationen. Statt eine externe Einrichtung vollständig von Hand einzutragen, kann direkt in ROR gesucht werden. Die ausgewählte Organisation wird eindeutig über ihre ROR ID angelegt und verfügbare Metadaten werden übernommen. Besonders praktisch: durch die korrekte Zuordnung der Koordinaten kann die Organisation direkt auf der Karte angezeigt werden.
Dieses Vorgehen verhindert, dass dieselbe Partnerorganisation mehrfach unter leicht unterschiedlichen Namen entsteht. Gleichzeitig verbessert die ROR ID spätere Auswertungen und den Austausch mit anderen Systemen. Wenn verschiedene Publikationen, Projekte und Kooperationen dieselbe ROR ID verwenden, lassen sie sich verlässlich derselben Organisation zuordnen.
Dennoch ist zu beachten, dass nicht alle Organisationen, die für Eure Forschung relevant sind, bei ROR gefunden werden können. Auch wenn bereits über 130.000 Forschungsorganisationen in ROR existieren, gibt es immer wieder im Projektpartner oder Förderer, die noch nicht aufgeführt sind – oder es vielleicht auch niemals sein werden. Denn vielleicht finanziert der lokale Bienenzüchterverein eure Forschung oder ein Projektpartner ist ein mittelständisches Unternehmen aus der Region. Die legen autorisierte Personen in OSIRIS manuell an und fügen idealerweise auch alternative Namen und gängige Abkürzungen hinzu, damit die Kolleg:innen sie auch finden können.
ISBN: Unverzichtbar für Bücher
Nicht alle Disziplinen publizieren auf dieselbe Weise. In vielen Natur- und Lebenswissenschaften stehen Zeitschriftenartikel mit DOI im Mittelpunkt. In den Sozial- und Geisteswissenschaften spielen dagegen Monografien, Sammelbände und Buchbeiträge eine deutlich größere Rolle. Viele davon besitzen bis heute keine DOI.
Hier ist die ISBN besonders wichtig. Sie identifiziert eine bestimmte Ausgabe eines Buches. Hardcover, Taschenbuch, E-Book oder eine Neuauflage können daher jeweils unterschiedliche ISBNs besitzen. Das ist wichtig für die Deduplikation: Zwei verschiedene ISBNs müssen nicht automatisch zwei verschiedene Werke bedeuten – sie können unterschiedliche Ausgaben desselben Titels kennzeichnen.
Bei Buchkapiteln ist die ISBN in der Regel dem übergeordneten Buch oder Sammelband zugeordnet, nicht dem einzelnen Kapitel. Sie hilft also bei der Identifikation des Publikationskontexts, ersetzt für das Kapitel aber keine eigene DOI.
ISSN für Zeitschriften
Die ISSN erfüllt eine andere Aufgabe. Sie identifiziert fortlaufende Publikationen wie Zeitschriften oder Schriftenreihen, nicht den einzelnen Artikel. Dabei können Print- und Onlineausgabe einer Zeitschrift unterschiedliche ISSNs besitzen, dennoch wird jede ISSN nur einmal vergeben und ist dadurch ein einzigartiger Identifier für eine Zeitschrift.
In OSIRIS werden Zeitschriften zentral gespeichert und können mit Publikationen und anderen Forschungsaktivitäten, z.B. Guthaben und Editoren-Tätigkeiten, verknüpft werden. So ist es möglich, neben dem Namen einer Zeitschrift auch weitere Informationen zu speichern, zum Beispiel der Verlag zu dem die Zeitschrift gehört, Kategorien und nach Jahren aufgelöste Metriken.
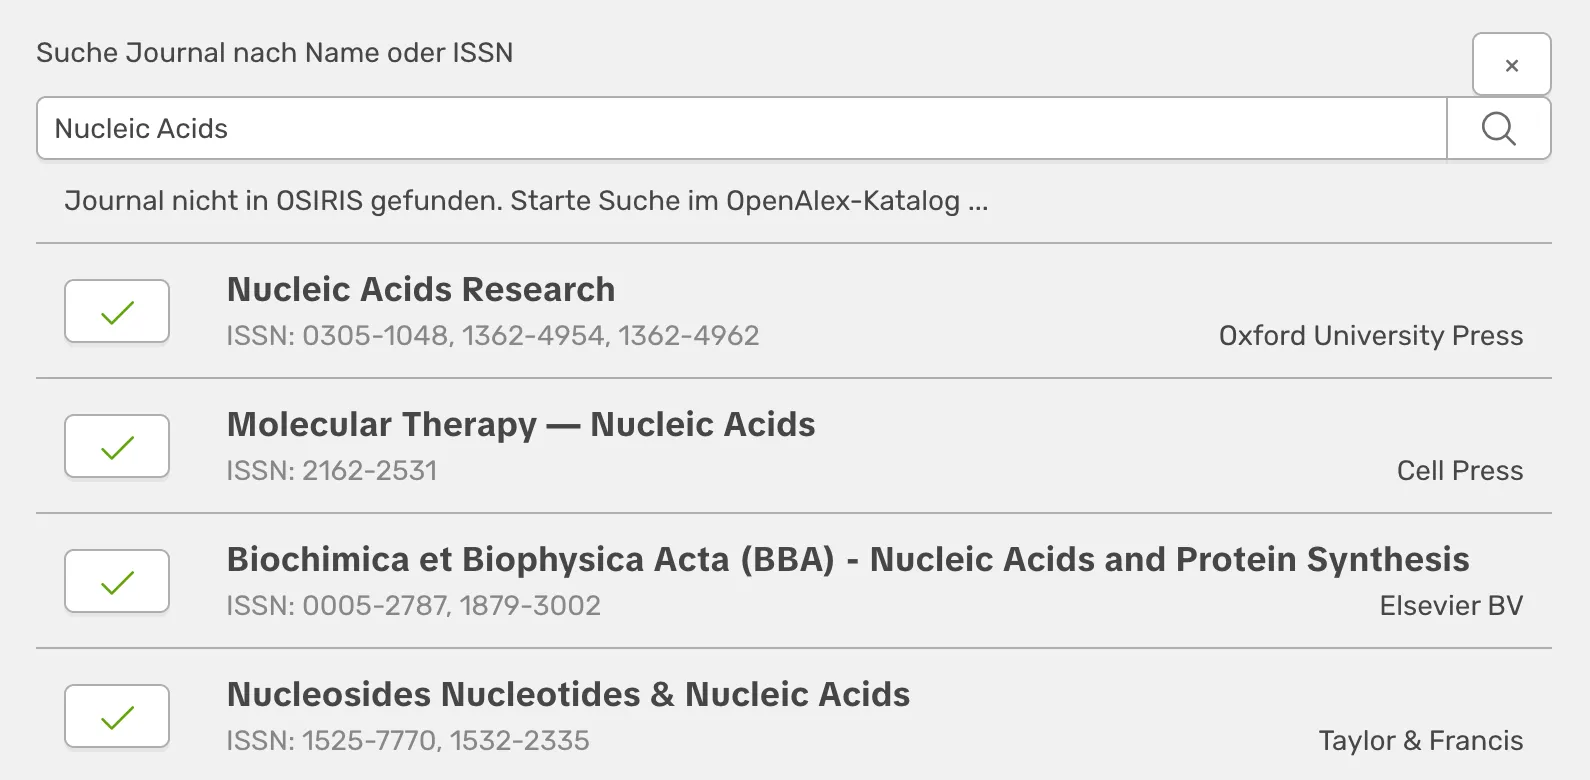
Idealerweise muss eine Zeitschrift jedoch nicht manuell angelegt werden, sondern wird über das entsprechende Feld beim Anlegen einer Aktivität hinzugefügt. OSIRIS verwendet dafür die offene Schnittstelle von OpenAlex, um Zeitschriften beispielsweise nach ihrem Namen zu finden. Noch besser ist, wenn man direkt mittels ISSN sucht, da diese als eindeutiger Identifier direkt zur richtigen Zeitschrift führt. Bereits existierende Zeitschriften werden dann verknüpft und fehlende werden neu angelegt. Die dafür notwendigen Metadaten zum Verlag, Open Access, usw. kommen ebenfalls direkt aus OpenAlex.
PMID und PMCID: Zentrale Kennungen in Medizin und Lebenswissenschaften
Die PubMed ID, kurz PMID, identifiziert einen Datensatz in der Literaturdatenbank PubMed. Sie ist in Medizin und Lebenswissenschaften weit verbreitet und eignet sich hervorragend, um Publikationen in diesem fachlichen Kontext eindeutig wiederzufinden.
Eine PMID ist nicht dasselbe wie eine DOI. Viele Artikel besitzen beide Kennungen, aber nicht jeder PubMed-Datensatz hat eine DOI und nicht jede Publikation mit DOI ist in PubMed indexiert. Beide IDs können deshalb sinnvoll nebeneinander gespeichert werden.
OSIRIS ist außerdem in der Lage in PubMed zu suchen und auch Metadaten aus PubMed zu importieren. Dafür muss nur die PubMed-ID in das Importfeld eingegeben werden. Der Import der Daten gestaltet sich ähnlich wie bei der DOI, allerdings muss man bei einigen Felder mit einer schlechteren Metadaten-Qualität rechnen.
Davon zu unterscheiden ist die PubMed Central ID, kurz PMCID. Sie verweist auf einen frei zugänglichen Volltext im Archiv PubMed Central. PMID und PMCID können sich also auf denselben Artikel beziehen, identifizieren aber Datensätze in unterschiedlichen Systemen und erfüllen unterschiedliche Zwecke.
Gerade an medizinischen oder lebenswissenschaftlichen Einrichtungen können diese fachspezifischen Kennungen die Datenqualität erheblich verbessern und zusätzliche Import- oder Abgleichmöglichkeiten eröffnen.
Preprints, Repositorien und Forschungsdaten
Manche Fachgebiete und Publikationstypen besitzen eigene etablierte Identifikationssysteme:
- arXiv-IDs sind besonders in Physik, Mathematik und Informatik verbreitet. Sie identifizieren Preprints und bleiben auch über neue Versionen hinweg nachvollziehbar.
- Handles und URNs werden häufig von institutionellen Repositorien, Bibliotheken und digitalen Sammlungen verwendet. Sie können beispielsweise Hochschulschriften dauerhaft adressierbar machen.
- Accession Numbers identifizieren Datensätze in Fachrepositorien, etwa Genomsequenzen, Proteinstrukturen, biologische Proben oder geowissenschaftliche Daten.
- Clinical-Trial-IDs kennzeichnen registrierte klinische Studien und verbinden Veröffentlichungen mit den zugrunde liegenden Studien.
- OpenAlex IDs identifizieren Entitäten im OpenAlex-Wissensgraphen. Für OSIRIS sind sie vor allem bei der Verknüpfung und Anreicherung von Forschungsinformationen interessant.
Forschungsdaten und Software erhalten zudem immer häufiger eine DOI, häufig über DataCite. Das macht deutlich, dass die DOI längst nicht mehr ausschließlich für klassische Artikel gedacht ist.
Ein Objekt kann mehrere Identifier haben
Mehrere Kennungen für dasselbe Objekt sind kein Widerspruch, sondern häufig ein Vorteil. Ein biomedizinischer Artikel kann gleichzeitig eine DOI, eine PMID, eine PMCID und eine OpenAlex ID besitzen. Jede dieser Kennungen verbindet ihn mit einer anderen Infrastruktur und eröffnet andere Nutzungsmöglichkeiten.
Entscheidend ist, die Kennungen korrekt zu modellieren:
- Die DOI identifiziert den publizierten Artikel.
- Die PMID identifiziert den PubMed-Datensatz.
- Die PMCID identifiziert den Volltext in PubMed Central.
- Die OpenAlex ID identifiziert das Werk im OpenAlex-Wissensgraphen.
Zusammen ergeben diese IDs ein dichteres Netz von Verbindungen. Fällt eine Datenquelle aus oder enthält sie nur wenige Metadaten, kann eine andere Quelle zusätzliche Informationen liefern. Auch beim Abgleich zwischen Systemen steigt die Chance, dass Datensätze zuverlässig zusammengeführt werden können.
Gute Identifier, bessere Forschungsinformationen
Identifier wirken auf den ersten Blick unscheinbar. Im Forschungsinformationsmanagement sind sie jedoch ein wesentlicher Teil der Dateninfrastruktur. Sie machen aus isolierten Datensätzen ein verknüpftes Informationsnetz.
Für die Praxis helfen einige einfache Grundsätze:
- Identifier möglichst früh erfassen. Eine DOI direkt beim Import ist hilfreicher als eine spätere manuelle Ergänzung.
- Zur Entität passende IDs verwenden. Eine ISSN identifiziert eine Zeitschrift, nicht den darin erschienenen Artikel; eine ISBN identifiziert eine Buchausgabe, nicht automatisch jedes Kapitel.
- Mehrere relevante IDs zulassen. DOI und PMID konkurrieren nicht miteinander, sondern ergänzen sich.
- Kennungen prüfen und möglichst aus vertrauenswürdigen Quellen übernehmen. Eine falsche ID kann Datensätze ebenso zuverlässig falsch verbinden wie eine richtige ID sie korrekt verbindet.
- Identifier nicht als bloße Links behandeln. Ihr größter Wert liegt in der maschinenlesbaren Verknüpfung und im automatisierten Datenaustausch.
Genau deshalb spielen Identifier in OSIRIS eine so zentrale Rolle. Die DOI vereinfacht den Import von Publikationen und verhindert Dubletten. ORCID verbindet Personen eindeutig mit ihrem internationalen Forschungsprofil. ROR sorgt dafür, dass Organisationen zentral, standardisiert und mit hochwertigen Metadaten angelegt werden. Die ISSN wird als eindeutiger Identifier für Journale ebenfalls zur Vermeidung von Dubletten und dem einfachen Import geführt. Fachspezifische Kennungen ergänzen dieses Netz dort, wo DOI, ORCID und ROR allein nicht ausreichen.
Je mehr Forschungsobjekte mit passenden, geprüften Identifiern versehen sind, desto weniger müssen Menschen und Systeme raten. Das verbessert nicht nur einzelne Datensätze, sondern die Qualität des gesamten Forschungsinformationssystems.
Gute Forschungsinformationen beginnen mit einer einfachen Frage: Wissen wir eindeutig, über was oder über wen wir eigentlich sprechen?